CEIC2026|AI越聪明,为什么反而越慢?
2026年09月24日 10:30
来源:消费电子创新大会CEIC组委会
地点:广东 深圳
这样的体验应该并不陌生:和 AI 进行简单对话时,回复几乎即时出现;但当任务变成分析几十页行业报告、梳理复杂逻辑或拆解专业方案,等待时间却明显变长,甚至可能出现任务中断。大模型的能力越来越强,能够处理的任务也越来越复杂,但真正面对长文档分析、深度推理、音视频生成等高负载任务时,AI 为什么仍然会“慢下来”?
很多人的第一反应,是网络不够快,或者应用本身的性能问题。但真正的瓶颈,往往还隐藏在更底层的算力系统中。面对性能问题,一个很自然的思路是增加硬件:AI 跑得不够快,就增加更多 GPU、NPU;芯片数量越多,理论算力越高,似乎就应该带来更快的处理速度。但在真实的计算系统中,芯片数量与整体性能并不是简单的线性关系。当算力集群扩大到一定规模,芯片之间的通信和数据传输成本会不断增加,甚至消耗掉相当一部分硬件性能。
01 芯片多了,算力未必更快
大模型、百万字超长上下文、AI 智能体、AI 视频生成等应用,正在越来越多地进入真实的工作和生活场景。与此同时,很多用户也发现:解析长篇文档、进行多轮复杂推理、生成图片和视频等任务时,等待时间往往明显增加。这并不完全是软件问题,很多时候,大量高性能芯片已经投入工作,但如果彼此之间的协作效率不高,整个系统仍然可能慢下来。
可以把它理解成一个由 100 位专业人士组成的团队:每个人能力都很强,但如果缺少统一、高效的协作机制,文件需要反复传递,信息需要频繁同步,大量时间就会消耗在沟通和等待上。团队规模扩大,并不意味着整体效率会同步提升。
类似的问题也存在于今天的 AI 算力集群中。单颗算力芯片本身拥有很强的计算能力,但当上百颗芯片共同处理任务时,需要持续交换大量模型参数、KV 缓存和激活数据。传统模式下,服务器之间的信息传递往往需要经过多层封装和转发,由此产生额外的通信开销。于是就会出现一种看似矛盾的情况:芯片还有计算能力,却不得不等待数据。这就是业内经常提到的“内存墙”和“通信墙”——瓶颈不只存在于芯片本身,也可能出现在芯片与芯片之间。
02 超节点:让一群芯片高效协同完成运算
面对大模型、AI 智能体等紧耦合的复杂任务,关键不再是简单增加高性能芯片的数量,而是让原本彼此独立的硬件资源高效协同,像一台完整的计算机一样统一运行。这正是「超节点」架构的核心思路。
需要澄清的是,超节点并不是某一块芯片,也不是某一台服务器。它通过高速互联总线机制,打破服务器之间的物理隔离,将分散的计算和内存资源连接起来,在逻辑上形成一台巨型计算机。这样做的目的,是减少芯片之间不必要的通信开销,让数据在不同计算资源之间更高效地流动,从而更充分地释放硬件本身的计算能力。
过去,我们更关注“一颗芯片能算多快”;进入大模型时代之后,还需要回答另一个更重要的问题:“一群芯片能不能高效地一起算?”算力竞争的关注点,也由单一硬件性能逐步延伸到整个系统的协同效率。
03 让不同的技术体系说同一种语言
要真正做到高效协同,还有一个现实问题需要解决:不同厂商的硬件,有着各自的技术体系。过去,提升 AI 计算能力,很大程度上依赖单颗芯片性能的提升;随着AI应用的普及和深入,计算任务越来越复杂,芯片、服务器、存储等不同硬件需要共同参与。
问题也随之出现:不同厂商的产品采用不同的协议、接口和技术体系,就像各自使用不同的技术“方言”。即使单台设备性能很强,如果彼此之间无法顺畅沟通,也很难形成真正高效的整体算力。跨厂商、跨架构的协同,仅靠单一企业很难完成,需要产业各方建立共同的技术语言与协作机制,统一基础概念和技术定义,推动接口与标准协同,并在真实业务场景中持续验证。
这正是全球计算联盟(GCC)等产业组织的重要价值:连接产业链上下游,搭建产业协作平台,推动行业形成共识与标准,让不同技术体系能够更高效地协同。
04 从标准共识走向规模应用
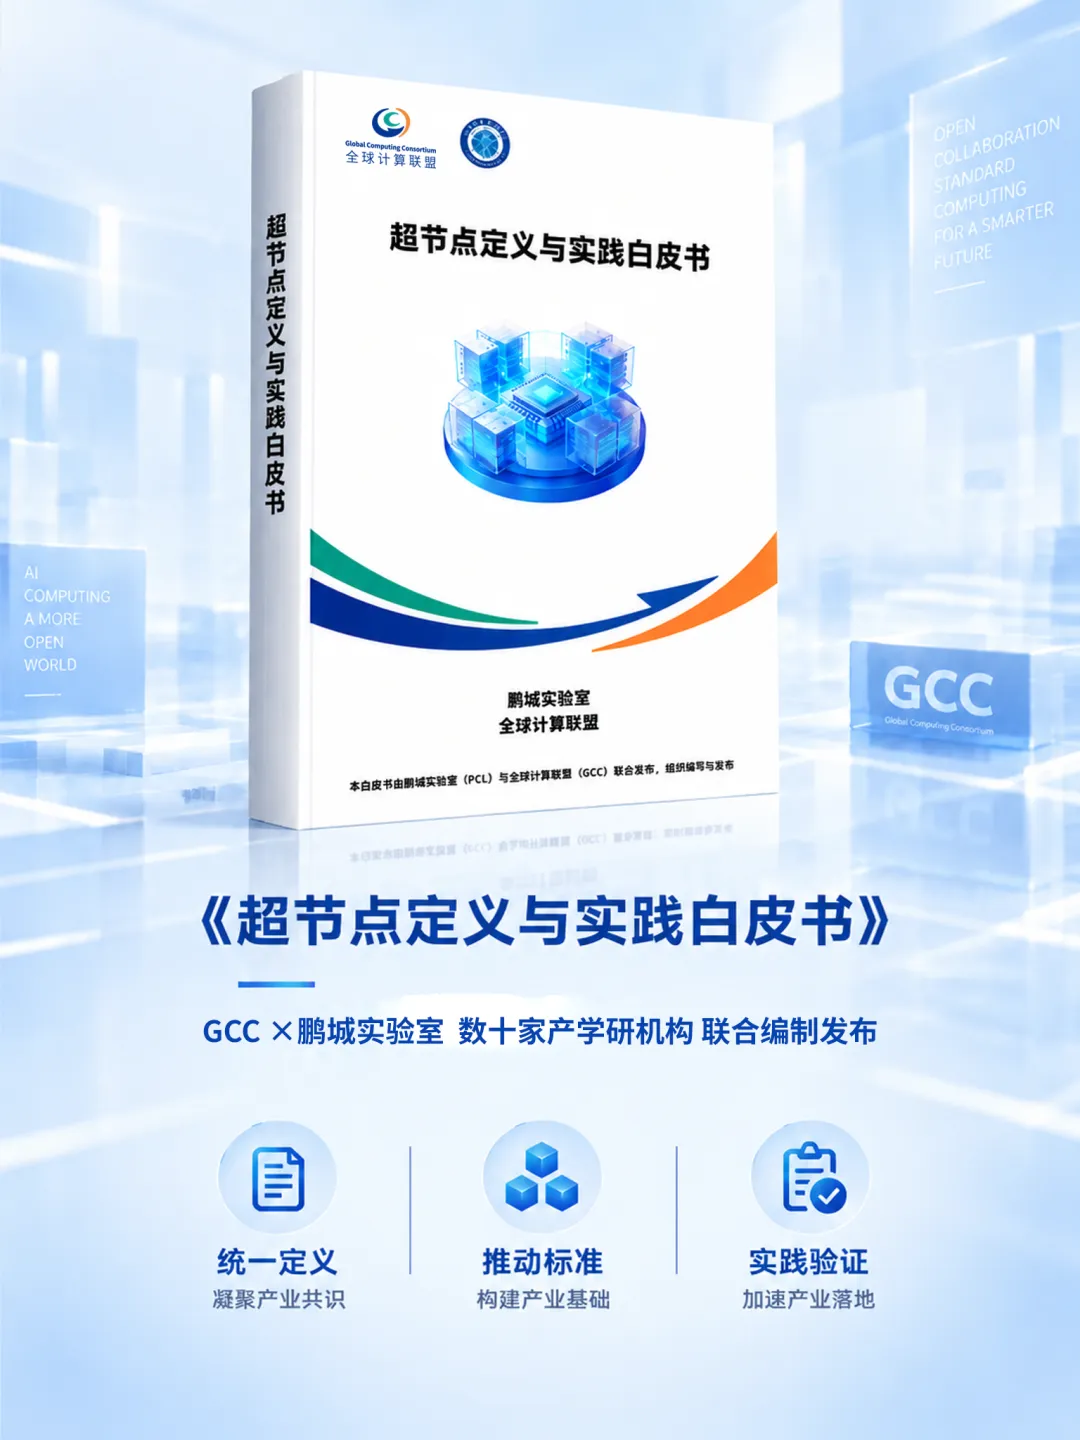
今年 8 月,GCC 联合鹏城实验室,汇聚数十家产学研机构,共同编制发布《超节点定义与实践白皮书》,系统梳理超节点的定义与实践路径。在统一产业认知的基础上,各方进一步推动互联总线、软硬件适配、运维可靠性等标准建设,并联合产业链上下游伙伴,在大模型训推、AI 智能体、数据库、大数据等真实业务场景中开展验证,降低产业落地门槛,推动超节点逐步走向开放、可复用的标准化生态。
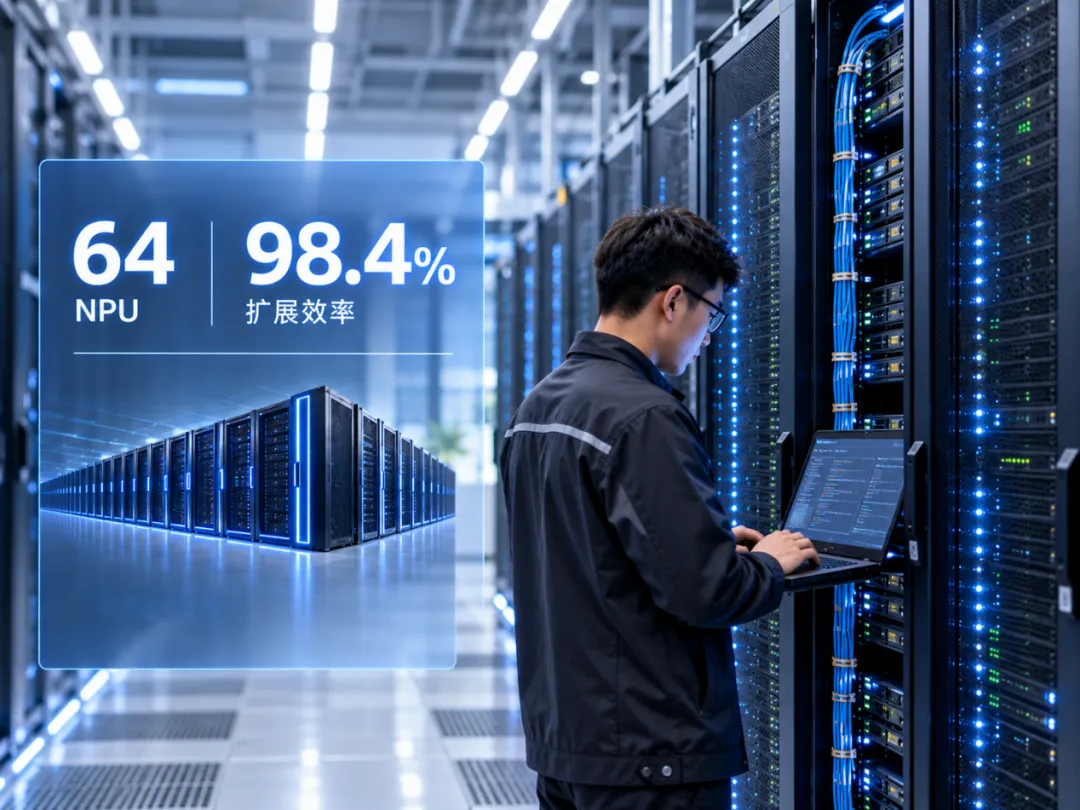
鹏城云脑Ⅲ提供了一个实际验证范例。作为国内首个采用超节点架构的国产智算集群,鹏城云脑Ⅲ通过 64 颗 NPU 紧密协同耦合,在千卡规模大模型训练场景下,实现了 98.4% 的扩展效率。产业界也已经在 MoE 大模型推理、超长对话等业务场景中开展实践验证,进一步提升 AI 系统的运行效率。从验证走向更大规模应用,超节点仍然需要解决两类重要的工程挑战。一方面,不同厂商的硬件技术体系各不相同,要实现跨品牌、跨架构的顺畅协同,需要在硬件、软件和接口层面进行大量适配;另一方面,当上百颗硬件资源组成一个大型计算系统后,任何局部故障都可能影响整体运行,这也对故障处理、系统可靠性和集群运维提出了更高要求。因此,超节点真正走向规模化应用,不仅需要更强的互联能力,也需要产业持续推进标准、兼容性和工程实践。
05 更快的 AI,更高效的算力
当开放、协同的算力体系逐步成熟,它带来的变化最终会回到真实的 AI 体验。对普通用户来说,使用 AI 分析长篇报告、进行复杂逻辑推理、生成音视频内容时,等待时间有望进一步缩短;随着系统整体效率提高,各类 AI 工具和云端服务也有机会以更高效、更稳定的方式提供服务。
对企业而言,建设算力中心时也可以拥有更灵活的硬件选择,不必完全依赖单一厂商的技术体系。不同品牌、不同类型的计算资源能够更高效地协同,电力与硬件资源的利用效率也有望进一步提高。与此同时,当标准、接口和工程实践逐渐成熟,中小企业也可以更多地复用已经验证的技术方案,降低从零开始建设和适配的成本。
AI 算力的竞争,正在从单颗芯片的性能比拼,走向整个计算系统的协同能力竞争。芯片强,只是入场券;系统协同强,才是真正的胜负手。